Hasura Japan User Group 3 - Hasuraの本番運用とセキュリティ
はじめに
これは 2020/11/28 の Hasura Japan User Group 3 という勉強会で発表する内容です。
今日話すこと
- Hasuraを本番運用している話
- Hasuraとセキュリティ
の大きく二部構成で話します。
詳しく聞きたいことがあれば途中でも掘り下げていただければと思います。
自己紹介
- しんのき @konoki_nannoki
- React歴3.5年、TypeScript歴3年、GraphQL歴2年、Hasura歴1年
- 8月のGraphQL Tokyo MeetupでHasuraについて喋りました Hasura とは何者か メリット・デメリット - Speaker Deck
- WASD Inc. CTO
- デジちゃいむというサービスを作っています デジちゃいむ - 店舗接客を革新するクラウドチャイム
- 現在はアミューズメント施設様の導入が多く、最近は飲食店様やホームセンター様の導入事例が徐々に出てきました
- アミューズメント業界のご縁もあり週間ファミ通様に取材されました
本日発売の週刊ファミ通の巻末特集で弊社とデジちゃいむに関するインタビュー記事が掲載されました!🎉
— しんのき (@konoki_nannoki) 2020年11月12日
自分たちのできることをがむしゃらにやっていたら、このように取り上げていただいて、とても励みになります☺️ pic.twitter.com/HSk5ta43JB
これまでの道のり
- 5月 βリリース
- Amplify Auth
- Hasuraパーミッション見直し
- 6月 iOS/Androidアプリリリース
- React Native(Expo)
- 8月 正式サービス開始
- クレカ課金はStripeを採用
- 9月 チャット機能
- GraphQL Subscription
- 10月 画像添付機能
- Amplify Storage
- 11月 位置情報機能
Hasuraを本番運用している話
国内スタートアップのHasura採用例(勝手に参照)
- WASD Inc.
- βリリース時のnote WASD Inc.という会社でCTOをやっています|Yudai Shinnoki|note
- ログラスさん
- diniiさん
プロジェクト構成
- monorepo構成
- 前回のKeiさんの資料が非常にわかりやすいです Hasuraを使ったフルスタックアプリケーション開発のための基盤構築
- 1つのリポジトリにプッシュすると3つのWebフロントエンド(後述)がVercelにデプロイされる
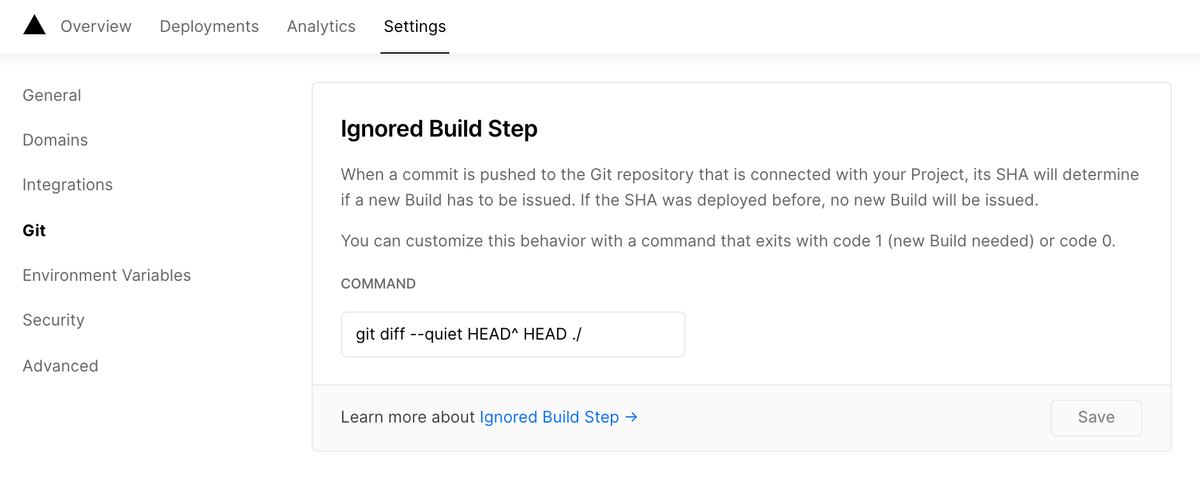
- Ignored Build Step を設定すると、対象のディレクトリが変更されていない場合はビルドがスキップされる
- GraphQL Code Generator(codegen)はYarn Workspacesのルートにインストールしている
ロールとパーミッションの設定
- 現在、user(ログイン済)、anonymous(匿名)、support(運営)の3ロール(とadminロール)
- 今のところロール毎にWebフロントエンドが分かれる形に落ち着いている
- 1つのApolloClient
x-hasura-roleを動的に切り替えるのは 🙅♀️- キャッシュが混ざって見えないはずのデータが見えてしまったり不具合の温床になる
- ApolloClient(というよりApolloProvider)ごと分離するべき
- そこまでやるのであればプロジェクトごとまるっと分けてしまったほうが良い
- ロール = 境界づけられたコンテキスト として、明確に分けることができるはず
- 公式ドキュメントのauthor-reviewer-editorのサンプル はミスリードだと思う
- codegenの設定に
x-hasura-roleをセットするのは非常にオススメ
schema:
  - http://localhost:8080/v1/graphql
      headers:
        x-hasura-admin-secret: myadminsecretkey
        x-hasura-role: user
Hasuraを使っててよかったこと
- スケールに合わせてインフラを選びやすい
- Hasura: Heroku → Fargate(isolated) → Fargate(private)
- Fargateに移したときにガチガチにprivate network内に閉じるようにしたら辛かったので少しゆるくした
- Hasura Cloud使ってみたいけど英語サポートとやりとりするコストを考え踏みとどまっている
- DB: Heroku Hobby → Amazon RDS for PostgreSQL → Amazon Aurora PostgreSQL
- Serverless Function: Serverless Framework → AWS CDK → Serverless Framework
- デプロイ遅かったので出戻りした
- Frontend: S3+CloudFront→ Amplify Console → Vercel
- コスト重視から機能重視に徐々に移行できた
- Next.jsを採用するために最近Vercelに移行
- monorepo対応や環境変数まわりの改善に合わせて移行できてよかった
- Hasura: Heroku → Fargate(isolated) → Fargate(private)
- 日々の開発にジョインするための学習コストが非常に低い
docker-compose upとyarn startだけで環境が立ち上がる
Hasuraを使っててつらいこと
- 日々の開発以上のことを勉強しようとすると覚えるべきことが多い
- パーミッションの設定には頭をつかうしレビューも難しいのでどうしても属人化する
- 後述するセキュリティまわり等は情報が少ないので自分たちで工夫するしかない
現状の感触
- もともと辛くなったらバックエンド書こうと考えていたけど、今はHasuraで突っ走れそうな気がしている
- どこでパフォーマンスの問題に直面するのかが未知
- DBで障害を起こすと辛いので割と早い段階からAurora db.t3.mediumを採用している
- 初期にpollingで実装したところをsubscriptionに書き換えたいけど、websocketはネットワーク環境の影響を受けやすいので移行を踏みとどまっている(2ヶ月ほど)
Hasuraとセキュリティ
チェックリスト
- 公式のProduction Checklistに従って設定すれば大丈夫
- Production checklist | Hasura GraphQL Docs
- 最初から全てやろうと思うと大変なので、できるところからやっていきましょう
- ただしパーミッションの設定についてはプロダクトに依るところがあるので、自分たちで責任をもってチェックする必要がある
- 大企業様のセキュリティチェックシートや脆弱性診断を通過しました
Actionsのパーミッション
- Actionsでは、ロールごとに許可/拒否の2種類しかない
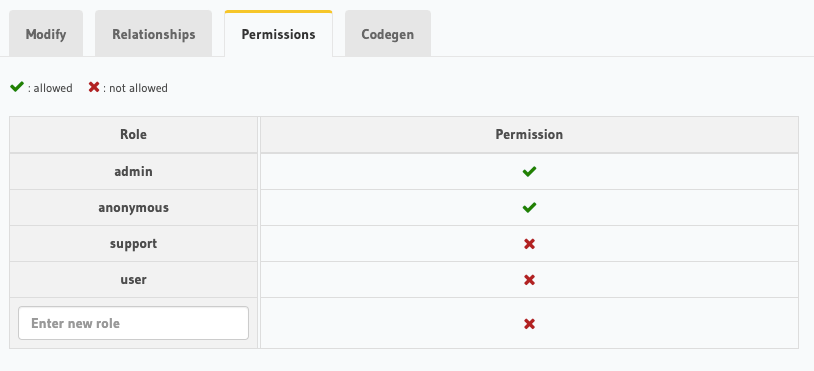
- DBのデータをもとにパーミッションのようなことがやりたかったら、Action Handler内からHasuraにQueryを投げ返し、引っ張ってきたデータをもとにロジックを書く
- 基本的にAction Handlerは 1つのQuery → 何かしらのロジックや外部通信 → 1つのMutation になるようにする
- 複数の更新処理を1つのMutationにまとめることでトランザクションしてくれるので、1つのMutationにまとめるのが大原則
- GraphQLは前のMutationの結果を拾って次のMutationに渡すことができない(知ってたら教えて下さい)
- 奥の手としてDatabase Triggerを使う
- Remote Schemaの場合はどうなんでしょう(あまり使っていない)
データのバリデーション
varchar(n)を使う(おすすめ)- PostgreSQLの
varchar(n)型はtextに文字数制限がついたもの(MySQLとは違う) - DBの定義に出てくるのでわかりやすい
- Hasura Console上の表示が微妙なのが残念...今後の改善に期待
- PostgreSQLの
- Check Constraints を使う
- 数値の大小や、カラム同士の比較が必要な場合
- 見通しがあまりよくないので、下の方法に寄せてしまったほうがよさそう
- ActionsやRemote Schema経由でデータを挿入する
- 複雑なロジックが必要な場合
- 何でもできる
実現できていないこと
- Admin Secretが外部に漏れたら好き勝手やられてしまう
- とはいえHasura ConsoleやMigrationがあるので、
x-hasura-admin-secretを全て拒否するのは難しい - 特定のIP以外だったらロードバランサ側で
x-hasura-admin-secretヘッダーをドロップすることができればよさそう - システム側からも
x-hasura-admin-secretを持ったリクエストが飛んでくるので、そちらの考慮も必要
- とはいえHasura ConsoleやMigrationがあるので、
- IP制限
- マルチテナントSaaSなので、テナント毎やユーザー毎にIP制限をかけられると嬉しい
- Auth Webhookで頑張ればいけなくもなさそうだけど、全てのクエリに対して毎回処理が走るのはしんどそう
- Hasura CloudのAPI limitsではこれはできないよね?API limits | Hasura GraphQL Docs
まとめ
- 0→1、1→10のフェーズのHasura採用は胸をはってオススメできる(パーミッションを理解している人が1人以上居る前提)
- ここから先どうスケールするかはまたどこかでご報告します
宣伝
- Hasura、TypeScript、Next.jsなスタックを実務で使ってみたいインターンや業務委託を募集しています!!
- しんのき @konoki_nannoki までリプやDMください!まずは気軽にお話しましょう
- フワッとした仕様を手を動かして形にしたい方大歓迎です
- Material UI、Storybook、テストの知見があると嬉しいです
- ゲーム、ゲームセンターが好きな人は特に楽しめると思います
- 昨日も皆でAmong Usやりました
WASDあさもく部 #5 開催レポート
はじめに
9/24(木) 8:00- 開催した Discord もくもく会のレポートです。
参加者は主催含め5名でした。
今日は寝起きが悪くて不安でしたが始まってみたら集中できました...!
自分のやったこと
Twilio Programmable Video の調査を行っていました。
React を使った公式の Example があるので API KEY を設定すればサクッとできるかなと思ったのですが、中身を見るとバックエンドでトークンの吐き出しを実装する必要がありそうで、ドキュメントの理解をやっていました。
雑談メモ
Elixir で GraphQL やってるひと初めて聞いた...!
JavaScript / TypeScript のメソッド引数のもたせ方
ざっくりとこんな感じのコードがある
export class Client {
  public static call(
    method = "GET",
    path: string,
    param1: boolean,
    option1?: JSON,
    option2?: any,
    option3?: any,
    option4?: boolean,
    option5?: Hoge = {},
    callback1?: string,
    callback2?: string
  ) { }
}
- メソッドの引数が多い
- どのようにパラメータを追加するか
- 途中に追加する
- 修正箇所が多い
- 呼出時に必要のないパラメータを渡す必要がある
- (どこまでするかはおいておいて)objectでパラメータを渡す
- 引数の順番を気にしなくていい
- 呼び出し側がパラメータの名前を知る必要がある
- このデメリットはTSだと薄い
- 関数やメソッドでこのようなインターフェースにするのはフロント・TS界隈で一般的なのか?
- 愚直に末尾に追加する
- 呼出時に必要のないパラメータを渡す必要がある
- コールバックの後ろにコールバック以外のパラメータがあるのが気持ち悪い
- 途中に追加する
- Fetch関数とかjQueryとかを参考にしてみるのがいいかも
Redux むずかしい
- Udemy ではむさん(プログラミングおじさん)の講座で勉強している
- Redux は初学者のハードルになっているよね
- 最近のコードだと Redux を使わないでも Context API で乗り切れる
- ちょっと前のコードの引き継ぎだと非同期通信で redux-saga が使われていたりするので、まだまだ勉強が必要な場面はある
所感
前回はトークテーマのネタ切れ感に悩まされていましたが、今回は初参加の方が多かったり質問を用意してくださっていたりしたので新鮮な話が多かったです!
次回は 10/1(木) 8:00- 予定です。
興味を持たれましたらぜひご参加ください!
WASDあさもく部 #4 開催レポート
はじめに
9/10(木) 8:00- 開催した Discord もくもく会のレポートです。
参加者は主催含め4名でした。
前日の深夜に本番デプロイ作業を行っていたので起きられるか不安だったのですが、なんとか起きられました...!
雑談メモ
- ExpoのOTAアップデートについて
- Deeplink踏んだときにreloadAsyncすると最後に踏んだやつがまた開いてしまう問題があるらしい
- https://stackoverflow.com/questions/52895818/linking-getinitialurl-is-not-being-cleared-after-used-for-deeplink
- reloadする前にAsyncStorageにフラグをもたせておく?
- Deeplinkを無視したあとにフラグを消す処理は必要そう
- react-navigationのLinkingOptionつかってる場合どうするんだろう
- expo build時にpublishされちゃう問題
- shinnokiはストアのバージョン毎にrelease-channel分けてます
- Expo SDKのバージョンが変わったら無視されるだけなので、新機能がストア公開前に出ちゃっても良いのであればrelease-channelひとつでいいかも
- Deeplink踏んだときにreloadAsyncすると最後に踏んだやつがまた開いてしまう問題があるらしい
- ところでAsyncってアシンクとエーシンクどっちが正しいの?
- よく話題になるけどエーシンクが正しい
- アシンクってよんでた・・・
- AsyncStorage(エーシンクストレージ)なんか言いづらい
- Reactで通信がオンラインかオフラインか表示したい
- 基本は
window.addEventListener('offline', func)とかでいけるらしい - react-adaptive-hooks
- https://github.com/GoogleChromeLabs/react-adaptive-hooks
- Google Chrome チームが React Hooks のライブラリを作ってるの面白い!
- Safariは対応していない...
- React Nativeの場合NetInfoを使う
- 基本は
GraphQLのクライアントについて
- いろいろ宗派がありますよね
- Apollo Client、Relay
- Relay Specは仰々しくなりがち
- Apollo Clientは便利だけどキャッシュの説明が難しい
- react-query、SWRとかもあるけどキャッシュの仕組みが微妙に違う
- https://engineering.mercari.com/blog/entry/2019-12-17-130000/
- SWRはキャッシュに主眼を置いているので取得の方法は自由
- いろいろ宗派がありますよね
Jamstackワークショップ来週なんですね
所感
今回は皆さんリピーターだったのですが、新しいトピックを出すのが難しいなという課題が見えました。(それが悪いことではないですが)
気軽に話しやすい雰囲気を作るために、うざすぎない程度にトークテーマを提供していこうと思います。
次回は 9/24(木) 8:00- 予定です。 (来週はお休み)
興味を持たれましたらぜひご参加ください!
WASDあさもく部 #3 開催レポート
はじめに
9/3(木) 8:00- 開催した Discord もくもく会のレポートです。
参加者は主催含め5名、うち初参加の方が2名でした。
1人はなんと他のもくもく会からはしごとのこと!
これより早い時間で終わるイベントがあるのはびっくりしました。
雑談メモ
ページネーションを Reducer 内で管理しているのですが、 Limit Offset ページネーションの maxPage を Reducer 内で持つにはどうすればいいですか?
- maxPage はどうやっても通信しにいかないと知ることができないですよね
- クエリの結果を受けてコンポーネント側で計算してもいいのでは
- Reducer に渡したいのであれば Action を投げる、ただし余計な render は発生する
Flipper って Expo でも使えるの?
- SDK 38 ではまだ
- https://dev.to/expo/expo-sdk-38-is-now-available-5aa0
Flipper is currently unsupported in the Managed workflow. If you want to use Flipper, you'll need to use the Bare workflow for now (but you can still use all your favorite Expo modules in the Bare workflow!).
- 39 でも対応予定的なのはなさそう
- Bare Workflow では使えますが、 Expo Client のことを考えると対応難しそうですよね
- SDK 38 ではまだ
JAM Stack 現状 Next.js と Gatsby どっちがいいの?
Next.js で実装しているけどメンテナンス工数をへらすために STUDIO 化を検討している
- STUDIO の CMS は制限が厳しいイメージ
- 記事の数がそこまで増えない想定であれば問題なさそう
Next.js と Apollo Client を組み合わせるのって前辛かったけど今もつらいの?
- つらいっぽい
Next.js と認証
- Auth0 の認証情報を _app.js で取りたい
- Automatic Static Optimization が効かなくなる
- この辺りの知見誰か〜〜
今度のイベント Remo でやるかも
- よさそう!
- ただ Remo ちょっとお高めなんですよね〜
- Spatial Chat も似たような感じ
所感
8:10 - 9:10 をもくもくタイムにしていますが、9時始業の方が参加しやすいように少しだけ短くするのもありかなと思いました
(これ以上時間を早くするのは参加者集めるのが難しそう)
次回は 9/10(木) 8:00- 予定です。
興味を持たれましたらぜひご参加ください!
続・ Hasura Allow List について(リスト管理の自動化)
しんのきです。
前回の記事で Hasura Allow List についてのの運用方法を考察しました。
次に世代管理ですが、
v1v2のようなバージョン管理だと崩壊しそうなので日付ベースの名前をつけたほうがよさそうです。そこで使わなくなったオペレーションは
<クライアント名>/<ロール名>/<オペレーション名>~<使わなくなった日時>のように名前を変更するとよさそうです。
命名規則については考察できたのですが、 Allow List を管理するために追加で手作業が発生してしまうため、どうしても開発スピードが落ちたりヒューマンエラーが発生しそうで導入を足踏みしておりました。
しかし先日の GraphQL Tokyo Meetup #10 にて Codegen の自作に関する LT に影響を受け、 yaml ファイルで管理される Allow List の metadata を自動生成するという着想を得たのでやってみました。
#GraphQLTokyo 今日のLT資料です。 https://t.co/wLzGcjFGAchttps://t.co/TcuYa88Yp5 も興味がある人は使ってみてください
— gql`quramy { name }` (@Quramy) 2020年8月28日
Meetup の様子は全て YouTube にアーカイブとして残っているのでぜひ御覧ください!
(しんのきもスピーカーとして参加しました)
Hasura が生成する metadata ファイル
Hasura は v1.2.0 以降で導入された config v2 から、データベースのマイグレーションは migrations ディレクトリに .sql ファイルとして、それ以外の Hasura に関する設定は metadata ディレクトリに .yaml や .graphql ファイルとして分けて出力されるようになりました。
(config v1 では全て同じディレクトリ内にあったので、 v2 になって分かりやすくなりパフォーマンスも向上しました)
Allow List に関係するのはmetadata/allow_list.yaml と metadata/query_collections.yaml という 2 つのファイルです。
metadata/allow_list.yaml は以下の内容で基本的に更新されることはありません。
- collection: allowed-queries
実際に Allow List に登録されたクエリは以下のような内容で metadata/query_collections.yaml に保存されていきます。
- name: allowed-queries
  definition:
    queries:
      - name: Posts
        query: |
          query Posts {
            posts: post {
              id
              body
              created_at
            }
          }
      - name: CreatePost
        query: |
          mutation CreatePost($object: post_insert_input!) {
            insert_post_one(object: $object) {
              id
              body
              created_at
            }
          }
metadata/query_collections.yaml は Allow List だけでなくクエリを保存しておく全般の用途で使われるようですが、現状で Allow List 以外に使われることがあるのかは不明です。
この metadata/query_collections.yaml を自動生成することができればかなり楽ができそうです。
(失敗した方法)GraphQL Code Generator の独自プラグインを実装する
現在 Hasura を採用している今のプロジェクトでは GraphQL Code Generator を使っているのですが、 GraphQL Code Generator では Custom Plugin として自分で書いたコードを差し込むことができるので、まずはこの仕組みに乗っかることができないか試してみました。
ドキュメントに書いてある通りにやってみたところ、かなり簡単に Custom Plugin を実装できました。
実際に yaml を返すプラグインを generate-allow-list.js という名前で以下のように実装しました。(yaml パッケージを利用しています)
const path = require("path");
const YAML = require("yaml");

module.exports = {
  plugin: (schema, documents, config, info) =>
    YAML.stringify([
      {
        name: "allowed-queries",
        definition: {
          queries: documents.map((doc) => ({
            // doc.location が絶対パスとして入ってくるので相対パスに直し
            // 拡張子を削除してクエリ名に使う
            name: path.relative(__dirname, doc.location).replace(/\.graphql$/, ""),
            // query には生のクエリを渡す
            query: doc.rawSDL,
          })),
        },
      },
    ]),
};
codegen.yaml で以下のように指定し実装した Custom Plugin が動くように設定します。
overwrite: true
schema: "http://localhost:8080/v1/graphql"
documents: "**/*.graphql"
generates:
  hasura/metadata/query_collections.yaml:
    - generate-allow-list.js
非常にスッキリ書けたのですが、実際に試しているうちに GraphQL Code Generator では同名の名前付き GraphQL オペレーションを複数読み込めないということが分かりました。
前回の記事で見たように Allow List を運用していくには同名のオペレーションを複数保存していって世代管理していきたかったので、これでは要件を満たすことができませんでした。
glob と fs を使って愚直にファイルを読み込む
もはや GraphQL の Codegen とは関係がなくなってしまっていますが、今回は GraphQL オペレーションの内容には興味がなくファイルの中身だけとれればいいので、 glob と fs を使って必要なファイルを読み込むだけでも十分使えるものが実装できました。
このときの generate-allow-list.js は以下のようになります。
const fs = require("fs");
const glob = require("glob");
const YAML = require("yaml");

// クエリリストを生成
const paths = glob.sync("**/*.graphql");
const queries = paths.map((path) => ({
  // 拡張子を削除してクエリ名に使う
  name: path.replace(/\.graphql$/, ""),
  // query にはファイルの中身をそのまま渡す
  query: fs.readFileSync(path, "utf8").toString(),
}));

// メタデータ保存
fs.writeFileSync(
  "hasura/metadata/query_collections.yaml",
  YAML.stringify([{ name: "allowed-queries", queries }])
);
GraphQL Code Generator とは関係ないので、 codegen コマンド時に実行されるように package.json の scripts を修正する必要があります。
(GraphQL Code Generator の Lifecycle Hooks に設定してもいいかもしれません)
{
  ...
  "scripts": {
    "codegen": "graphql-codegen && node generate-allow-list.js",
  }
}
Allow List の世代管理を実装する
fs を使えば更新前の metadata/query_collections.yaml の内容を取得して比較することもできるので、ちょっと頑張って前回考察した命名規則を使った世代管理についても自動化できるように実装しました。
そこで使わなくなったオペレーションは
<クライアント名>/<ロール名>/<オペレーション名>~<使わなくなった日時>のように名前を変更するとよさそうです。
最終的な generate-allow-list.js は以下のようになりました。
const fs = require("fs");
const glob = require("glob");
const YAML = require("yaml");
const dayjs = require("dayjs");

const GLOB_PATTERN = "**/*.graphql";
const METADATA_PATH = "hasura/metadata/query_collections.yaml";

// クエリリストを生成
const paths = glob.sync(GLOB_PATTERN);
const queries = paths.map((path) => ({
  // 拡張子を削除してクエリ名に使う
  name: path.replace(/\.graphql$/, ""),
  // query にはファイルの中身をそのまま渡す
  query: fs.readFileSync(path, "utf8"),
}));

// 現在のクエリリストを取得
const currentQueries = YAML.parse(fs.readFileSync(METADATA_PATH, "utf8")).find(
  (item) => item.name === "allowed-queries"
).definition.queries;

// 互換用クエリリストを生成
const timestamp = dayjs().format("YYYYMMDDHHmmss");
const compatQueries = currentQueries.flatMap((q) =>
  queries.some(({ query }) => query === q.query)
    ? // 同じ内容のクエリがあれば無視する
      []
    : // クエリ名にタイムスタンプが付いていなければ付与して保存
      [
        {
          name: q.name.match(/~\d+$/) ? q.name : `${q.name}~${timestamp}`,
          query: q.query,
        },
      ]
);

// クエリリストをマージして名前順にソートし直す
const mergedQueries = [...queries, ...compatQueries].sort((q1, q2) =>
  q1.name.localeCompare(q2.name)
);

// メタデータ保存
fs.writeFileSync(
  METADATA_PATH,
  YAML.stringify([
    {
      name: "allowed-queries",
      definition: {
        queries: mergedQueries,
      },
    },
  ])
);
この状態でメタデータを生成し hasura metadata apply するといい感じに Allow List に反映できました。
一覧性もよく管理しやすそうです。
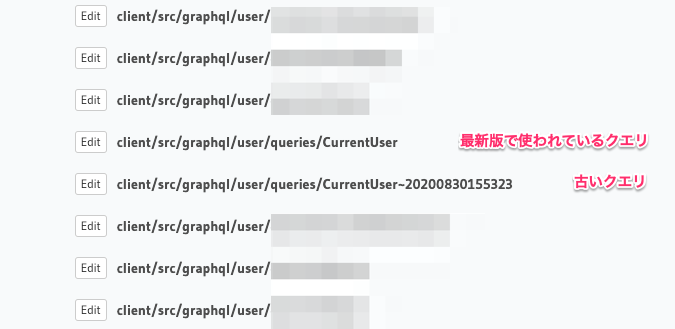
開発していると古いクエリがどんどん溜まっていくので、フロントエンドの更新が行き渡り完全に使われることが無くなってから metadata/query_collections.yaml から手動で取り除くことで完全に削除されます。
まとめ
ようやく開発効率を落とさずに Allow List を導入できそうです!
Hasura Cloud を使うと Allow List 機能が強化されブロックしたオペレーションを確認してその場で Allow List に登録できるようになりますが、それでもデプロイ直後のエラーは避けられないので今回のやり方は有用かと思われます。
普通に使っていると Allow List の管理は面倒だと思うのですが、現実的な運用方法に関する情報がどこにも転がっていなく、ここまでたどり着くまでだいぶ苦戦しました。
これでしばらく運用してみて、良さそうだったら npm パッケージとして公開したり英語の記事も書きたいですね。
Hasura の Allow List でセキュリティを強化する
しんのきです。
今回は Hasura の Allow List 機能について、業務で必要になったので調査しました。
この内容は先日主催した Disocrd もくもく会で取り組んだものです。
来週もやる予定ですが、もう少しターゲットが分かりやすいように名前を変えて後ほど公開予定です!
GraphQL とセキュリティ
GaphQL は 1 つのエンドポイントに対してクライアントから送られるオペレーションによって Query で取得できるデータや実行される Mutation が変わるという性質上、仕組み的に何かしらのセキュリティ対策を施さないと悪意あるオペレーションによって大量データを取得されてしまったり意図的に重い処理を走らせてかけてサービスに負荷をかけることが可能です。
下記の記事で詳しく説明されていますが、 GraphQL のセキュリティ対策としてオペレーションの複雑度を計算して重いオペレーションを弾く方法と実行可能なオペレーションを予めホワイトリストとして登録しておく方法の 2 つが知られています。
Hasura では Allow Llist という機能によってホワイトリスト方式のセキュリティ対策に対応しています。
(余談ですが、これからは BLM 的な意味合いでもホワイトリストよりは Allow List と呼んだ方が良さそうですね)
使い方
Hasura コンソールから Allow List を追加するには、設定画面の Allow List 選択し、 Add operation manually で画面上でオペレーションを入力するか Upload graphql file ファイルをアップロードします。
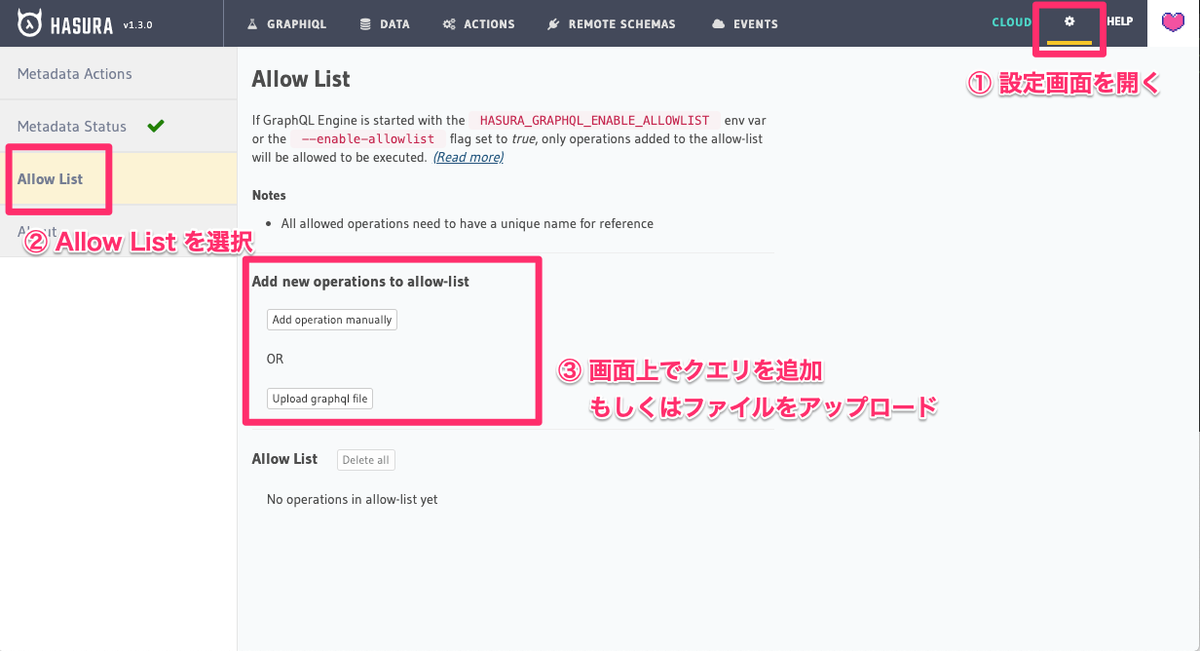
ファイルアップロードを利用する際は、 Allow List のオペレーション名としてファイル名ではなく GraphQL の名前付きオペレーションの名前が使われますので、必ず名前付きオペレーションである必要があります。
オペレーション名が重複していなければ、 1 つのファイルで一括して複数のオペレーションを登録することが可能です。
スクリーンショットの注意文にも書いておりますが、 Allow List を設定しても実際にはデフォルトでは機能が有効になっておらず、有効にするには環境変数に HASURA_GRAPHQL_ENABLE_ALLOWLIST=true をセットする必要があります。
公式ドキュメントでは、開発環境では Allow List を無効にして、ステージング環境や本番環境では Allow List を有効にすることが推奨されています。
注意点として、実際に使ってみて初めて分かったのですが、テーブルのマイグレーションやパーミッションと違い hasura console コマンドを使っていても Allow List の設定は自動的にメタデータとして保存されませんでした。
これが意図的な挙動なのかどうかはわかりませんが、少なくとも現時点では追加した Allow List をローカルに保存するためには hasura metadata export コマンドを使用する必要がありそうです。
懸念点
SPA やネイティブアプリがクライアントとして API と通信している構成において、 デプロイ戦略は慎重に考えなければなりません。
クライアントと API のデプロイを極力同時に行うようにしても、ユーザーがページを開きっぱなしだったりアプリの更新を行わない場合、最新のクライアントでは使用していない古いオペレーションを使い続けてしまう可能性があるためです。
このような課題があるため GraphQL では一般的に極力後方互換性を保つような API の追加が推奨されているのですが、 Allow List 込みで考えるとこれは更にシビアになります。
つまり使わなくなった古いオペレーションもしばらく世代管理して Allow List に残しておいて、本当に必要がなくなったことが確認できてから消去するというようなデプロイ戦略が求められます。
ここで、同じ名前の名前付きオペレーションを複数登録しておけるのかというのがドキュメントを読んだ上での懸念点でした。
というのも、先ほど使い方で見たように、 Allow List とオペレーション名が密接に関係していそうだったからです。
ファイルアップロードを利用する際は、 Allow List のオペレーション名としてファイル名ではなく GraphQL の名前付きオペレーションの名前が使われますので、必ず名前付きオペレーションである必要があります。
オペレーション名が重複していなければ、 1 つのファイルで一括して複数のオペレーションを登録することが可能です。
もし同じ名前の名前付きオペレーションが登録できないのであれば、実装を進めていくにあたってオペレーションの中身をちょっと変更する度にオペレーション名も変更する必要があり面倒です。
というわけで今回、同じ名前の名前付きオペレーションを複数登録できるかどうか調査しました。
調査結果
できました。めでたし!
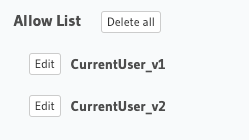
分かりづらいですが、全く同じ内容の CurrentUser という名前付きオペレーションを別の名前で登録しています。
ということで、名前付きオペレーションの名前と Allow List の名前は別物で、独立して設定可能であることが分かりました。
運用方法の考察
Allow List のオペレーション名は自由に設定できるということがわかったのですが、ここまでニッチな部分のベストプラクティスなど英語を含めてまだどこにも転がっていなく、自分たちで運用方法を考えていく必要がありました。
自社で開発しているサービスでは Web とネイティブアプリで名前が重複した CurrentUser というオペレーションが存在します。
そこでまず <クライアント名>/<ロール名>/<オペレーション名> を基本にするのがわかりやすそうです。
web/user/CurrentUser # Web から呼び出される
native/user/CurrentUser # ネイティブアプリから呼び出される
次に世代管理ですが、 v1 v2 のようなバージョン管理だと崩壊しそうなので日付ベースの名前をつけたほうがよさそうです。
そこで使わなくなったオペレーションは <クライアント名>/<ロール名>/<オペレーション名>~<使わなくなった日時> のように名前を変更するとよさそうです。
web/user/CurrentUser # 最新版
web/user/CurrentUser~20200822 # 2020/08/22に使わなくなったオペレーション
名前に入れる日時としては、作成日時よりは使わなくなった日時をベースにしたほうが「使わなくなって 1 ヶ月以上放置されているぞ」ということに気づきやすいと思い、この命名規則を考えました。
~ という記号を使ったのは GraphQL であまり使われることがないからです。
(補足) Hasura Cloud
Hasura Cloud を使うと Allow List 機能が強化され、オペレーションが最後に実行された時間を確認できたり、ブロックしたオペレーションを確認してその場で Allow List に登録できるようになります。
現在 beta で提供されているというのと、機能のキャッチアップが追いつかないため採用は見送っていますが、この機能を使えば Allow List の管理がぐっと楽になりそうです
まとめ
自社サービスで Hasura を使っているのですが、 Allow List を使うとセキュリティは強化できるものの開発効率は確実に落ちますので、ギリギリまで採用を見送っておりました。
機能追加にあたって徐々にセキュリティを強化する必要が出てきたのですが、今回の調査によって運用できそうなイメージが掴めたのでさっそく使っていこうと思います。
@graphql-codegen/typed-document-node を使ってみた
しんのきです。
自社サービスで Apollo Client の fetchMore を使ったページネーションを実装する際、出たばかりの TypedDocumentNode を思い出し、これを使えばもっとシンプルに型定義できそうだと思って調査してみました。
結果としては大きなハマりどころもなく期待通り動いてくれました。
(ちなみにドキュメントにもまだ反映されていませんが、 fetchMore と updateQueries を使ったページネーションは Apollo Client v3 で deprecated になっています。これはまた別のお話。)
TypedDocumentNode とは
TypedDocumentNode は graphql-codegen など GraphQL 関連のツール群を作っている The Guild が 2020 年 7 月にリリースした、 GraphQL ライブラリ用の TypeScript の型定義パッケージです。
型定義のみのパッケージですので何か新しい機能があるわけではありませんが、多数存在する GraphQL ライブラリ間で統一的な型定義を提供することによって graphql-codegen や他の GraphQL ライブラリ自体のメンテナンス性を上げることを目的としています。
下記の issue がベースのアイディアとなっています。
各ライブラリの対応状況として、 Apollo Client では v3.2.0(現時点ではまだbeta)から標準で対応されますが、それ以前のバージョンや他のライブラリでも @graphql-typed-document-node/patch-cli を用いてパッチを当てることで利用可能になります。
使い方
graphql-codegen をセットアップ後、例えば React と Apollo Client を使用している場合は typescript-react-apollo プラグインを設定しますが、これを typed-document-node に変更します。
schema: SCHEMA_FILE_OR_ENDPOINT_HERE
documents: "./src/**/*.graphql"
generates:
  ./src/graphql-operations.ts:
    plugins:
      - typescript
      - typescript-operations
      - typed-document-node
https://graphql-code-generator.com/docs/plugins/typed-document-node#usage-example
注意点として、現時点では typescript-react-apollo と typed-document-node を同時に設定してしまうと DocumentNode の定義が重複してエラーになってしまいます。
すでに typescript-react-apollo を使っていて段階的に移行したい場合、同じファイルに両方出力するのではなく別々のファイルに出力する必要があります。
これについては issue が上がっているので近いうちに対応されるかもしれません。
今までの graphql-codegen との違い
例えば以下のような Query を定義したとします。(user_by_pk は Hasura を使った場合の例です)
query User($id: uuid!) {
  user: user_by_pk(id: $id) {
    id
    name
  }
}
typescript-react-apollo を使うと以下のようなコードが生成されます。
import { gql } from "@apollo/client";
import * as Apollo from "@apollo/client";
export type Maybe<T> = T | null;
export type Exact<T extends { [key: string]: unknown }> = {
  [K in keyof T]: T[K];
};

export type Scalars = {
  ID: string;
  String: string;
  Boolean: boolean;
  Int: number;
  Float: number;
  uuid: string;
};

export type User = {
  id: Scalars["uuid"];
  name: Scalars["String"];
};

export type UserQueryVariables = Exact<{
  id: Scalars["uuid"];
}>;

export type UserQuery = { user?: Maybe<Pick<User, "id" | "name">> };

export const UserDocument = gql`
  query User($id: uuid!) {
    user: user_by_pk(id: $id) {
      id
      name
    }
  }
`;

export function useUserQuery(
  baseOptions?: Apollo.QueryHookOptions<UserQuery, UserQueryVariables>
) {
  return Apollo.useQuery<UserQuery, UserQueryVariables>(
    UserDocument,
    baseOptions
  );
}
これをコンポーネント側で呼び出す際は以下のように生成されたカスタム Hook を呼び出します。
import { useUserQuery } from "./generated";

// ...

const { data, error, loading } = useUserQuery({
  variables: {
    id: userId,
  },
})
一方、 typed-document-node を使うと以下のようなコードが生成されます。
import { TypedDocumentNode as DocumentNode } from "@graphql-typed-document-node/core";

// 同じなので省略

export const UserDocument: DocumentNode<UserQuery, UserQueryVariables> = {
  kind: "Document",
  definitions: [
    {
      kind: "OperationDefinition",
      operation: "query",
      name: { kind: "Name", value: "User" },
      variableDefinitions: [
        {
          kind: "VariableDefinition",
          variable: { kind: "Variable", name: { kind: "Name", value: "id" } },
          type: {
            kind: "NonNullType",
            type: { kind: "NamedType", name: { kind: "Name", value: "uuid" } },
          },
          directives: [],
        },
      ],
      directives: [],
      selectionSet: {
        kind: "SelectionSet",
        selections: [
          {
            kind: "Field",
            alias: { kind: "Name", value: "user" },
            name: { kind: "Name", value: "user_by_pk" },
            arguments: [
              {
                kind: "Argument",
                name: { kind: "Name", value: "id" },
                value: {
                  kind: "Variable",
                  name: { kind: "Name", value: "id" },
                },
              },
            ],
            directives: [],
            selectionSet: {
              kind: "SelectionSet",
              selections: [
                {
                  kind: "Field",
                  name: { kind: "Name", value: "id" },
                  arguments: [],
                  directives: [],
                },
                {
                  kind: "Field",
                  name: { kind: "Name", value: "name" },
                  arguments: [],
                  directives: [],
                },
              ],
            },
          },
        ],
      },
    },
  ],
};
UserDocument の中身が長いですが、これは typescript-react-apollo で export const UserDocument = gql`...` で定義した結果と同じです。
注目するべきは DocumentNode がクエリの返り値と引数の型を知っているということです。
コンポーネント側では以下のように呼び出します。
import { useQuery } from "@apollo/client";
import { UserDocument } from "./generated";

// ...

const { data, error, loading } = useQuery(UserDocument, {
  variables: {
    id: userId,
  },
});
UserDocument を渡した時点で useQuery の型が推論され、 useUserQuery と同じように data と variables に型が付与されたに変化します。
メリット
インタフェースが統一される
上記の例で分かる通り typed-document-node で生成されたコード内には @apollo/client などの特定の GraphQL ライブラリへの依存がありません。
TypeScript で graphql-codegen を使いたければ typed-document-node だけ理解すればあとのライブラリは自由に選べるという作りになっています。
またライブラリを作る側としてのメリットも大きく、今後 TypedDocumentNode を中心としたエコシステムでライブラリの改善スピードが上がる可能性があります。
Hooks 以外の型付与がやりやすくなる(React + Apollo Client の場合)
Apollo Client ではキャッシュを考慮しながら作り込んでいくとカスタム Hook 以外で GraphQL クエリを発行しなければいけない場面がいくつかあります。
具体的には fetchMore, subscribeToMore, refetchQueries がこれに該当するのですが、 これらの関数に対しても TypedDocumentNode を渡した時点で型推論が行われるようになるため、型付与がやりやすくなります。
import { useQuery } from "@apollo/client";
import { SampleOneDocument, SampleTwoDocument } from "./generated";

const { data, error, loading, fetchMore } = useQuery(SampleOneDocument);

const onLoadMore = async () => {
  await fetchMore({
    query: SampleTwoDocument,
    updateQuery: (prev, { fetchMoreResult }) => {
      // prev は SampleOneQuery, fechMoreResult は SampleTwoQuery | undefined
    }
  });
}
まとめ
TypedDocumentNode は実際触ってみてもライブラリの製作者にとっても利用者にとってもメリットがある仕組みだと感じました。
このように既存のシステムが出来上がってしまっているものに異を唱えて最適化できる人はすごいですね。
大きなデメリットは特に無いように思いますが、強いて言えば useFooQuery, useBarMutation となっていたものが全て FooDocument になってしまうため見分けが付きづらいことでしょうか。
この辺りも typed-document-node のオプションとして改善されていきそうな気がしています。
最後に宣伝です。
こんな感じの技術調査タスクが溜まっているので、 Discord でつなぎながらもくもくする会を企画しています。
興味がございましたらぜひご参加ください!
hasura migrate create --from-server について
きっかけ
Twitter 上で @kei_fff さんが Hasura の enum について紹介されていたことがきっかけで、こんなやりとりをしていました。
この機能まだ使ったことないけど、 hasura migrate create --from-serverやったときにちゃんと出力されるのかな?
— しんのき (@konoki_nannoki) 2020年8月10日
普通の実データは失われるけど... https://t.co/uEnOHUUAzC
確かに...
— Kei@Webエンジニア⛱ (@kei_ffff) 2020年8月10日
enumの値自体はinsert文でマイグレーションファイルの中に入れてく感じなんですけど、hasura migrate create --from-server 経由だと消えちゃいますね...
なのでenumを使う限りはmigrationの差分をコードで管理するようにして、localからapplyする運用にしないと厳しそうな気がします...
Hasura には hasura migrate create "<migration-name>" --from-server というコマンドで現在のテーブルの状態からマイグレーションを生成する機能があります。
当然ながらここで生成されるのはマイグレーションファイルなのでテーブル内のレコードはダンプされません。
一方で、テーブルを enum として設定するためにはテーブル定義が特定の条件を満たした上で 1 つ以上のレコードが必要です。
この 2 つの機能の矛盾について気になったので調査してみました。
結果
enum として設定したテーブルを作成した状態で hasura migrate create "init" --from-server コマンドを実行してみましたが、マイグレーションファイルの中に enum のレコードは含まれませんでした。
その状態で データベースが空の状態から hasura/graphql-engine:v1.3.0.cli-migrations-v2 イメージを起動してみたところ起動にコケました。
enum を定義する場合は Hasura Console から INSERT 文をマイグレーションとして作成するか、マイグレーションファイルを手動で編集して INSERT 文も含める必要がありそうです。
Hasura v1.3.0 から seeds ディレクトリにシードデータを定義できるようになりましたが、 cli-migrations イメージを使ったローカル開発のことを考えると migrations と metadata の間に差し込むことは難しいので、 docker-compose up するだけで環境が立ち上がるという手軽さは失われてしまうのであまり相性はよくなさそうです。
ついでに
自社のサービスで使っている割と複雑なテーブル定義に対して --from-server を使ってみたのですが、上記の enum の問題の他にも 独自定義した CREATE FUNCTION が中で使用しているテーブルの CREATE TABLE より先に定義されてしまってコケるという問題がありました。
適度に --squash や --from-server を使ってマイグレーションを整理できれば migrations と metadata 内のファイルを見るだけで把握できる一覧性の良さを獲得できるかなと期待したのですが、ちょっとひとクセありそうですね。
Hasura を Amazon RDS for PostgreSQL に接続するときの Dockerfile を供養する
これは何
Secrets Manager に RDS の接続情報を保存する際、 JSON 形式で保存されますが、Fargate は Secrets Manager から JSON キーを指定しての取り出しに対応していない(まだ対応されていない様子だった)ため、 jq コマンドを持ったコンテナイメージを作って実行時に動的に HASURA_GRAPHQL_DATABASE_URL にマッピングしていました。
使わなくなって消すのももったいないので残しておきます。
RDS のパスワードをローテーションする場合に使えるかもしれません。
# Dockerfile
FROM stedolan/jq as jq
FROM hasura/graphql-engine:v1.2.2

COPY --from=jq /usr/local/bin/jq /usr/local/bin/jq

COPY docker-entrypoint.sh /usr/local/bin/

ENTRYPOINT ["docker-entrypoint.sh"]

CMD ["graphql-engine", "serve"]
# docker-entrypoint.sh
#!/bin/sh

if [ -z ${HASURA_GRAPHQL_DATABASE_URL+x} ]; then
  export HASURA_GRAPHQL_DATABASE_URL=$(echo $DB_SECRET | jq -r '"postgres://" + .username + ":" + (.password|@uri) + "@" + .host + ":" + (.port|tostring) + "/" + .dbname')
fi

exec "$@"
password には記号が入る可能性があるので .password|@uri をつかってエスケープしています。
現在は
この方法はやめてシンプルに Secrets Manager に別途 Secret String 形式で RDS への接続 URL を保存してしまっています。
コンテナイメージは普通の hasura/graphql-engine を使っています。
はじめはローカルや CI/CD 環境からから Admin Secret を持ってマイグレーションを叩きに行くよりもセキュリティ的にいいだろうと思い cli-migrations 版のイメージをベースにマイグレーションファイルを COPY してコンテナイメージを生成していたのですが、毎回コンテナをデプロイしていると結構時間がかかってしまっていたため、今は諦めて外からマイグレーションしています。
Hasura の Role と Permission について理解する
しんのきです。
Hasura の Tips 的なやつをバンバン書いていきたいのですが、とりまとめがないのでしばらく個人ブログに書きたいことを書いていきます。
概要
例としてログイン済のユーザーが記事を投稿でき、ログインしていないユーザーでも記事を閲覧できるようなサービスを考えます。
テーブル設計は単純に以下のようになります。
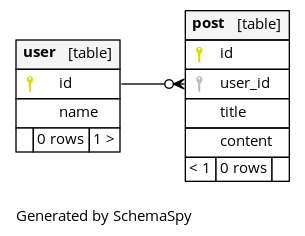
テーブル設計が済んだところで、 Hasura ではこのようなサービスを Role と Permission を設定することによって直感的に表現できます。
Role と Permission を用いて表現すると、
userおよびanonymousRole はuserおよびpostを自由に select できるuserRole はuser.idもしくはpost.user_idが自分のユーザーIDと一致する場合に insert / update / delete できる
というように表現されます。
Role の名前は自由に決めることができますが、今回のような場合 user と anonymous というように名付けると分かりやすいです。
例えば post の Permission は以下のように設定できます。
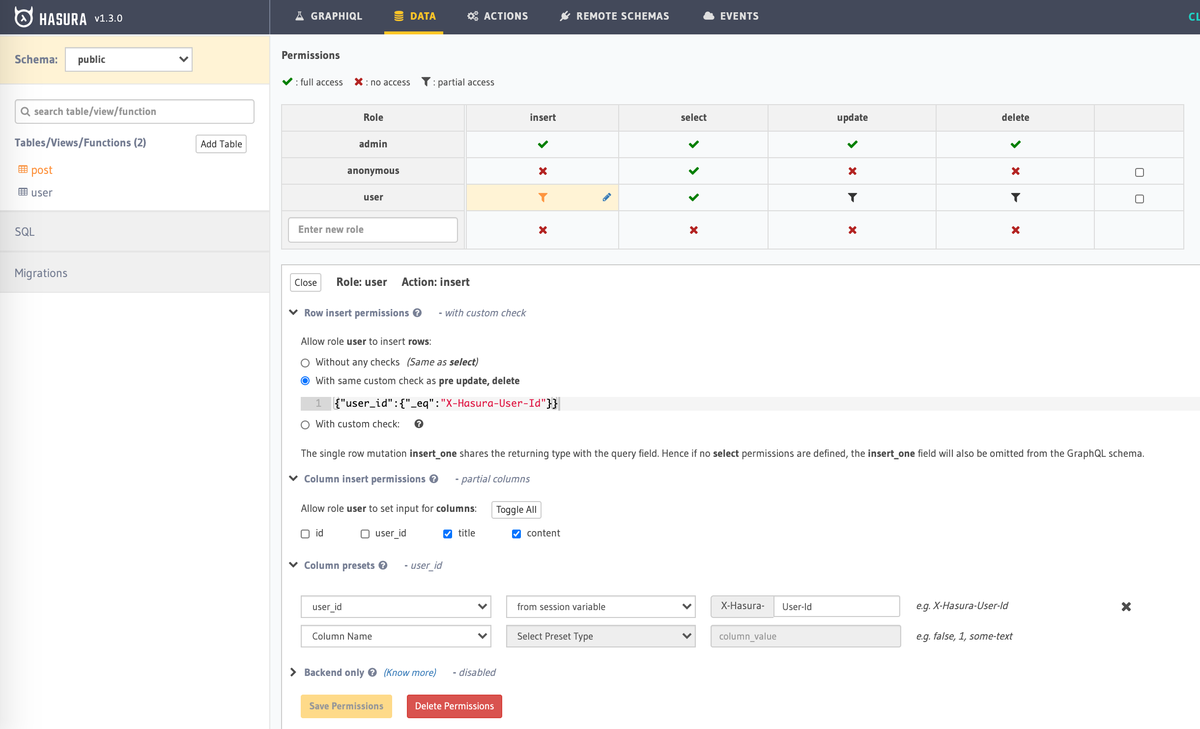
✔ になっているのがフルアクセス許可、 ✘ はアクセス拒否、フィルターっぽいアイコンになっているのが条件付きのアクセス許可です。
細かくは割愛いたしますが post.id はデータベース側で自動生成、 post.user_id は毎回 mutation で渡さないでも自分のユーザーIDが自動で入ってくれるような設定にしているので user からは insert できないようにしています。
どのように Role が決定されるのか
Hasura にアクセスする際の Role は以下のいずれかの方法によって決定されます。
Role の機能を使うには前提として HASURA_GRAPHQL_ADMIN_SECRET の設定が必須なので注意してください。
JWT 認証
Authentication using JWT | Hasura GraphQL Docs
登録された JWKs にマッチする JWT が Authorization: Bearer ヘッダーにセットされた場合、その JWT の中身が使われます。デフォルトでは https://hasura.io/jwt/claims というネームスペースの JWT claim の中身が利用されますがこのネームスペースは設定により変更可能です。
この JWT を持ったアクセスは x-hasura-allowed-roles で指定された Role になることができ、デフォルトでは x-hasura-default-role で指定された Role が使用されますが x-hasura-role ヘッダーを追加で渡すことで x-hasura-allowed-roles で許可された Role であれば使用できます。
他にも x-hasura-* で始まる名前の claim が渡されると Hasura でパースされ Session Variables として Permission Rule や Column Presets 内で利用が可能です。
JWT の sub を x-hasura-user-id にセットするという使い方が多いです。
webhook 認証
Authentication using webhooks | Hasura GraphQL Docs
登録されたエンドポイントに問い合わせ、レスポンスとして Role や Session Variables を返却してもらいます。
基本的に JWT 認証のほうがシンプルでパフォーマンスも良いはずなので、特別な理由がない限りまずは JWT 認証を検討するのがおすすめです。
匿名アクセス
Unauthenticated / Public access | Hasura GraphQL Docs
JWT もしくは webhook で認証できなかった場合、 HASURA_GRAPHQL_UNAUTHORIZED_ROLE がセットされていればその Role が使われます。
任意の Role が設定できますが、基本的には anonymous という名前を使うことになるでしょう。
Admin アクセス
リクエストヘッダーに正しい x-hasura-admin-secret がセットされた場合は今までの全ての設定が無視され、デフォルトで admin という Role が適用されます。
admin は最初から存在する特別な Role で、全ての Permission が許可され全てのデータに自由にアクセスできます。
Hasura Console はこの Admin アクセスを利用しています。
このとき同時にリクエストヘッダーに x-hasura-* で始まるヘッダーを渡すことで任意の Session Variables を渡すことができ、その中でも x-hasura-role を渡すことによって任意の Role になることができます。
Role ごとに見えるスキーマそのものが変わる
Hasura の面白い挙動の一つだと思うのですが、Role と Permission が設定されると権限のないテーブルやフィールドはただアクセスできないだけではなくその Role から見みたスキーマから消失します。
これと先ほどみた x-hasura-admin-secret と x-hasura-role を同時に渡すと任意の Role になれるということを知っていると便利な使い方ができます。
Hasura Console で Role ごとのクエリを試す
Hasura Console の GraphiQL のヘッダーに x-hasura-role を追加してあげると、任意の Role になりきってクエリを試すことができます。
分かりやすい例でいうと今回のサンプルプロジェクトで Hasura Console を開き GraphiQL のヘッダーに x-hasura-role: anonymous を指定すると、 anonymous Role には実行できる mutation が1つもないので右に表示される Docs から mutation そのものがその場で消えます。
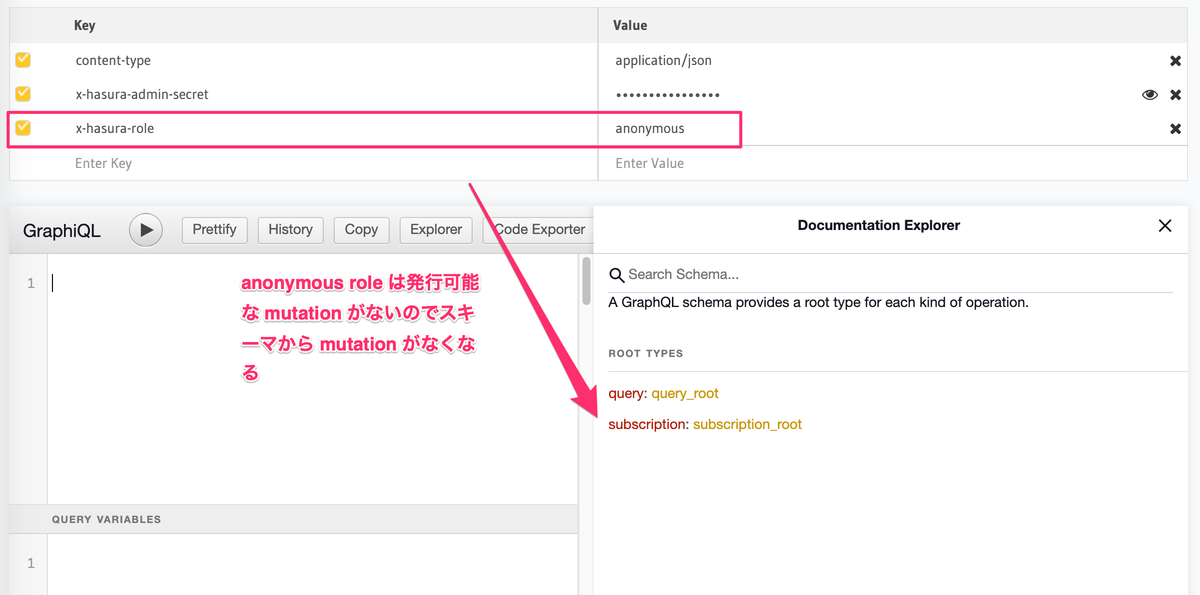
また Admin アクセスでは 任意の Session Variables を渡すことができるので、 x-hasura-role: user と x-hasura-user-id を渡すことで任意の user になりすましてクエリの実行が可能です。
GraphQL Code Generator で Role ごとのコードを自動生成する
今回一番伝えたかったのがこれです。これは非常に強力です。
Hasura と GraphQL Code Generator を組み合わせて使うとき、 HASURA_GRAPHQL_ADMIN_SECRET をセットしている場合は codegen.yml のほうにも x-hasura-admin-secret をセットしてあげる必要があります。このとき x-hasura-role を一緒に渡してあげることで特定の Role のスキーマに沿って codegen できます。
schema:
  - http://localhost:8080/v1/graphql
      headers:
        x-hasura-admin-secret: myadminsecretkey
        x-hasura-role: user
この設定をするメリットは大きく二つあり、一つ目は Role ごとに必要な型定義のみが生成されることです。例えば最初に見た例で insert 権限のない id フィールドを誤って渡したりするようなことはなくなりますし、 codegen されたファイルの行数もスッキリします。
もう一つが権限のないフィールドを読みに行こうとすると codegen に失敗することです。codegen に成功し TypeScript のエラーが出ていないという時点で通信まわりでフロントエンドがクラッシュしないことがかなりの精度で保証されるため、開発効率が非常に良いですしリファクタリングもやりやすくなります。
1つのクライアントに対して極力1つの Role にしたほうがいい
下のドキュメントなどを見ると author reviewer editor というように細かく Role を分けていますが、少なくとも Apollo Client からアクセスする場合はこのような分け方は個人的におすすめしません。
Access control examples | Hasura GraphQL Docs
これは Apollo Client のキャッシュの仕組みに関係しており、上で見たようにヘッダーを動的に変えるとスキーマそのものが変化しますが、同じ client でこれをやってしまうと異なるスキーマのデータが同じキャッシュに保存されることになってしまうためです。
また issue はあがっていますが現状 Role 間での Permission の継承などはできないため、似たような Role であっても全て個別に設定する必要があります。
Can role permissions of hasura be inherited? · Issue #611 · hasura/graphql-engine · GitHub
まずは Permission Rule を使って1つの Role でうまく表現できないかを検討してみるのがいいと思われます。
Apollo Client を使っていて、どうしてもページによって Role を使い分る必要がある場合は ApolloProvider ごと切り分けられるとよさそうです。
まとめ
Hasura の Role と Permission は最初はとっつきづらいですが、理解さえしてしまえば通常のバックエンドを実装するよりも早いのはもちろんのこと、使いこなせれば堅牢な API が作れる可能性があります。
バックエンドをコードとして実装するよりもできることは限られてくる分、データベースの設計がより重要になってきます。
というところで最後に宣伝となりますが、 SaaS のデータベース設計ができるエンジニアを募集しております。
すみません、しばらくこんな感じで最後にぶっ込んでいくと思います。
